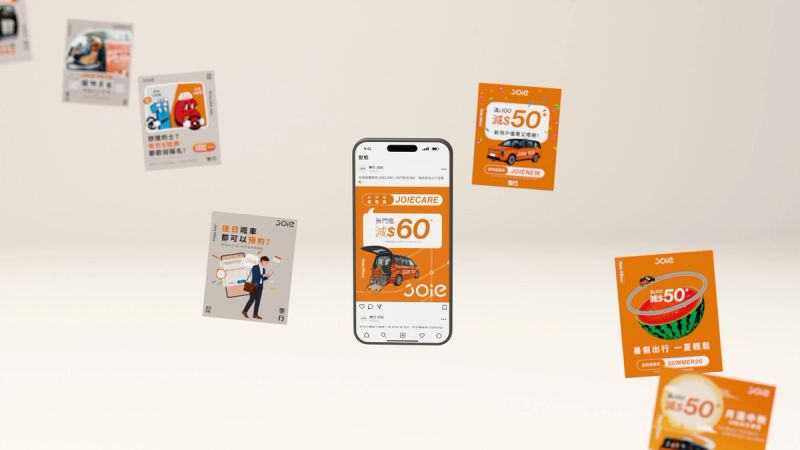
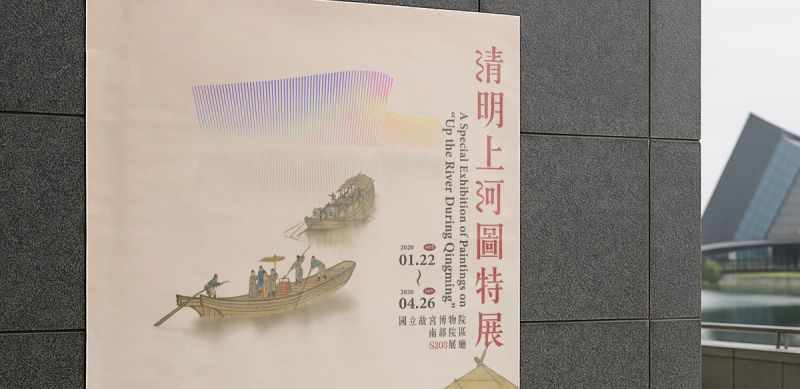
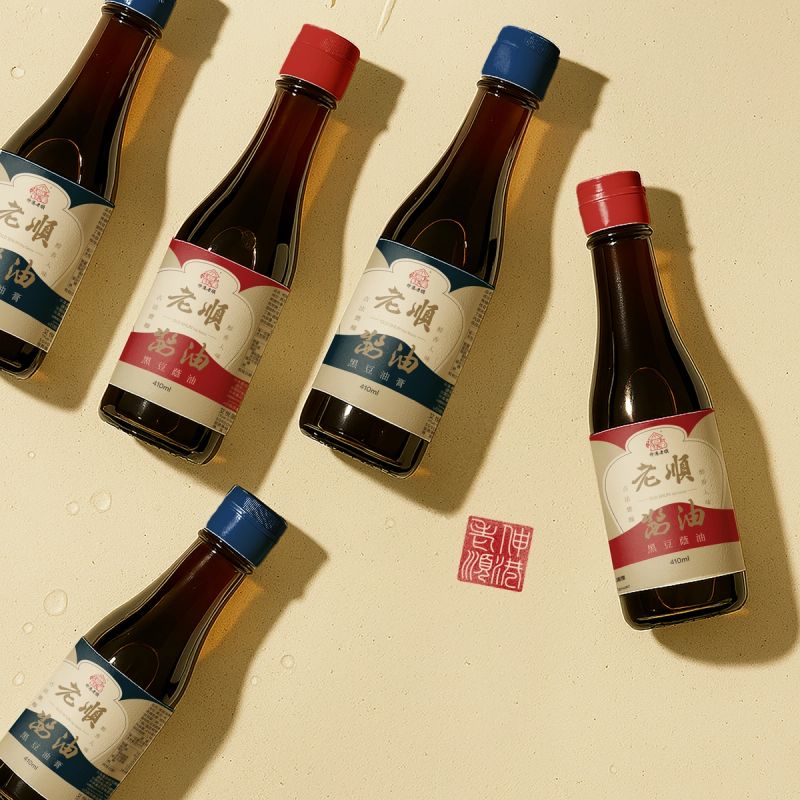
一件設計的深度,常常來自一個連結。把一種工藝的結構帶進版面,把一段歷史的節奏放進動線,把某個地方的生活方式轉成色彩。
每接起一個精準的點,作品就多一層。
技術有天花板
比例、字級、配色、完稿,這些技術都有標準,可以練習,也可以檢查。練到一定程度,設計師之間的差距會縮小;工具普及之後,差距又更小了。
技術讓作品完成。作品能走多深,取決於它背後的連結。
連得遠,也要連得準
連結的距離越遠,作品越難被取代。距離遠,也越容易失準。
一個失準的連結,看起來也許很聰明,放進作品裡卻顯得牽強:觀眾讀不懂,或讀成了另一個意思,或和品牌本身沒有關係。一個精準的連結,放進作品之後像是本來就在那裡,觀眾不需要說明,就能感覺到它對。
精準的意思是:符合這個品牌、這群觀眾、這個時間點。同樣的連結,換了對象就可能失效。
連得遠,作品才有深度;連得準,深度才能成立。
AI 給的是可能,人給的是準確
AI 讀過的東西,遠遠超過任何一個人。
以公開資料為例,2024 年發布的 Llama 3 語言模型,訓練時使用了超過 15 兆個 token 的文字;常用來訓練圖像生成模型的 LAION-5B 資料集,收錄了約 58.5 億組圖文配對。token、字詞和圖文配對不是同一種單位,無法直接換算;它們共同說明的是資料規模。
所以 AI 能跨越領域建立連結,範圍比任何人都廣。給它一個題目,它能在幾秒內提出許多說得通的方向。
說得通,不等於準確。這些資料再多,也不包含這個品牌經歷過什麼、這群觀眾在意什麼、哪一種說法在這個地方會被誤讀。要讓它變準,需要把脈絡一點一點提供給它。脈絡越多,耗費的運算越多;脈絡也需要被記錄與維護,才可能延續到下一次任務。
AI 的成本,大部分花在逼近精準。
人的精準從哪裡來
一個人擁有的資料少得多。
假設一個人每年讀 50 本書,持續 40 年,總共約 2,000 本。若每本以 10 萬字計,大約是 2 億字。BabyLM 研究則以約 1 億字詞作為模擬兒童語言接觸量的資料基準。這些數字不能和模型的 token 直接相比,但量級上的差距很清楚。
用這麼少的資料,人仍然能做出精準的判斷,原因在於資料的性質。人的經驗是親身經歷的、被挑選過的,而且每一段都連著結果:哪個顏色在某個場合讓人不安,哪句話曾經被誤解,哪個東西放進某個空間之後顯得突兀。一個人一生經歷的場合和對話有限,但每一段都留下了驗證過的判斷。
所以人往往不需要試很多次。一趟旅行、一本書、一次和工匠的談話,就可能成為往後多年都用得上的判斷依據。人腦運作所需的能量大約只有二十瓦,比一盞燈泡還少。
資料少,判斷卻準,因為每一筆都有經驗作為依據。
判斷會累積,精準會延續
每一個專案都會留下判斷。哪些連結成立,哪些看似聰明卻站不住,哪些在提案時成立、放進真實的場景卻失效。這些經驗不需要重新輸入,會留在設計師身上,成為下一次判斷的依據。
時間越長,判斷越準。新的經驗修正舊的經驗,一個領域的理解延伸到另一個領域。累積到一定程度之後,就成了一般所說的眼光。
AI 能調用的脈絡,取決於資料如何被保存與提供;人則帶著所有過去的判斷面對下一個題目。
設計的上限在哪裡
工具可以完成執行,也可以提供大量的可能。哪一個連結準確,要由人判斷。
設計的上限取決於兩件事:能把多遠的東西接在一起,以及接起來的東西是否準確。前者決定深度,後者決定深度能否成立。
結語
技術讓作品完成,連結讓作品有深度,精準讓深度成立。
AI 擅長提供可能,人擅長判斷準確。這份準確來自經驗,而且會隨著時間累積。
善用連結,設計才走得遠。
幾個值得停下來想的問題
- 你作品裡最重要的那個連結,換一個品牌或一群觀眾,還成立嗎?
- 一個連結「說得通」和「準確」,你怎麼分辨?
- 最近一次被否定的方向,是距離不夠遠,還是不夠準?
- 你的判斷,有沒有從一個專案延續到下一個專案?